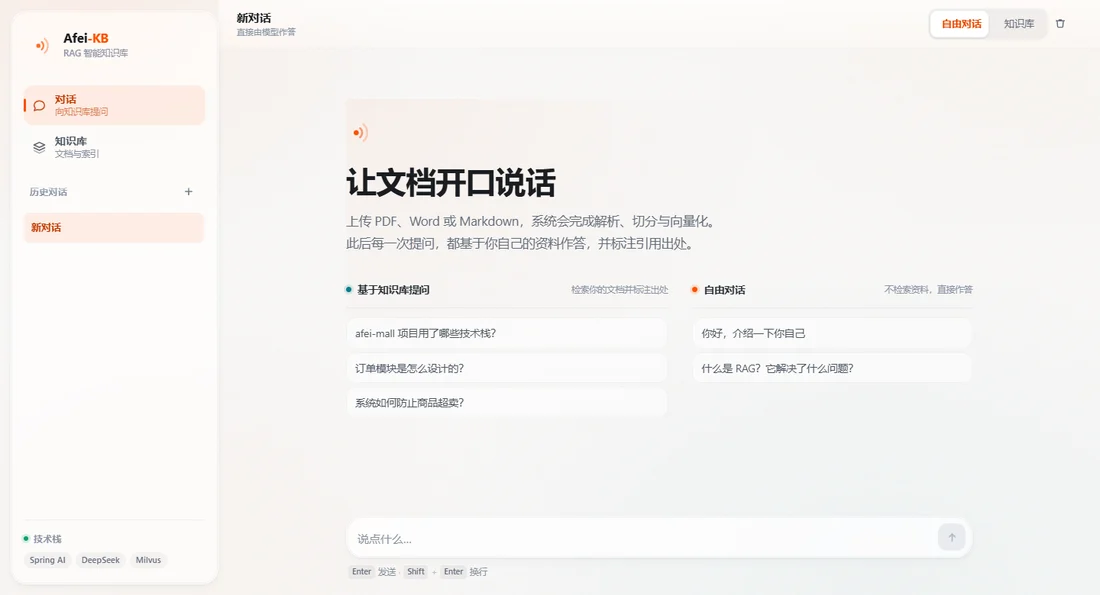
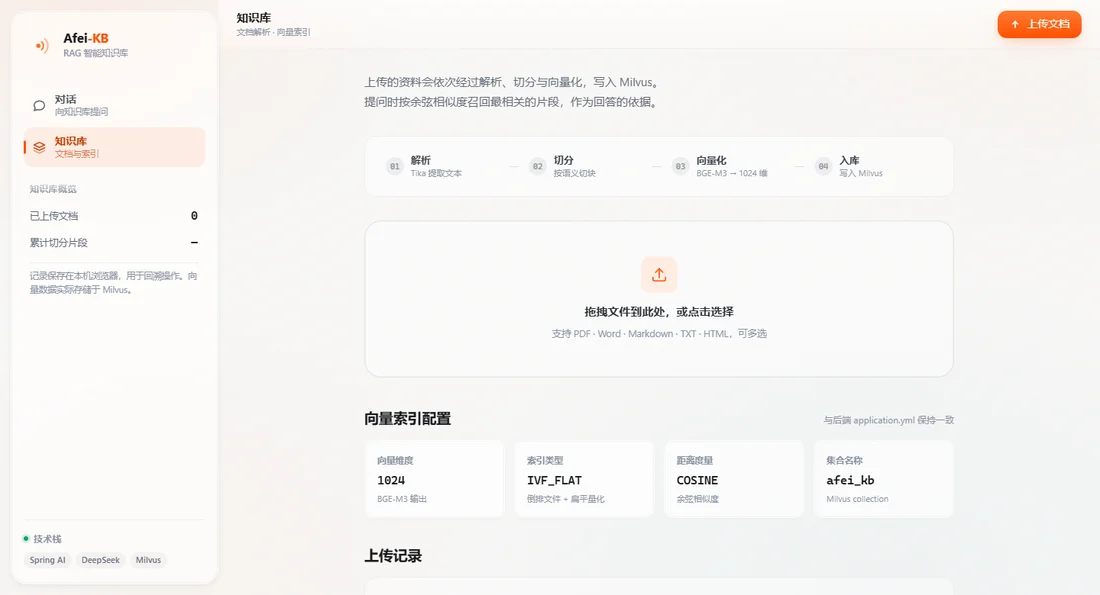
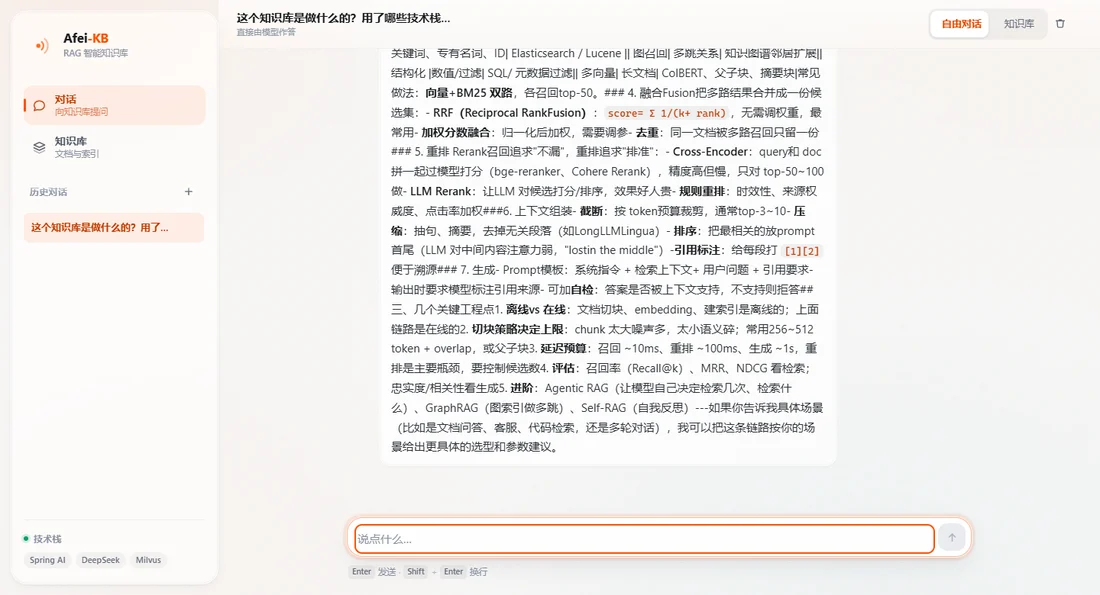
阿飞知识库 · afei-kb
技术栈
AI 框架
Spring AI
大模型
DeepSeek
向量库
Milvus
嵌入模型
BGE-M3
技术亮点
◆
文档切块与向量化:BGE-M3 + Milvus
◆
检索增强生成:先检索、再让模型基于资料作答
◆
多轮上下文:把历史对话一起带进检索与提示词
◆
回答 grounded:让模型只根据检索到的内容作答
这是什么
一个基于 RAG(检索增强生成) 的智能知识库问答系统。
把文档切块、向量化存进向量库;提问时先检索相关片段,再让大模型只根据检索到的内容作答。
为什么不用「直接问大模型」
大模型不知道我的资料,而且会一本正经地编。RAG 把「回答的依据」从模型的记忆换成了可检索的文档,
再配合明确的提示词约束,让回答能追溯到具体片段。
技术栈
| 环节 | 选型 | 作用 |
|---|---|---|
| 编排 | Spring AI | 把「检索 → 拼提示词 → 调用模型」这条链路框架化 |
| 生成 | DeepSeek | 负责根据检索结果组织答案 |
| 向量库 | Milvus | 存 embedding,支持大规模相似度检索 |
| Embedding | BGE-M3 | 文本向量化,中文效果好 |
| 记忆 | 会话上下文 | 多轮对话时把历史一起带入 |
三个需要动脑的地方
1. 切块策略
切块大小直接决定检索质量:块太大,检索到的片段里噪声多,模型容易被无关内容带偏;
块太小,关键信息又被切碎。最后按语义边界(段落 / 小标题)切,并保留一点重叠。
2. 检索不是「取 Top1」
一次多取几个候选片段,让模型自己判断哪几段真正相关。
另外要控制上下文总长度——塞太多片段反而会让答案变差。
3. 多轮对话的上下文
用户问「它的缺点呢」时,「它」指的是上一轮的某个实体。
所以要把历史对话一起参与检索(否则检索不到正确片段),并在提示词里明确当前指代对象。
收获
这个项目让我真正理解了:RAG 的效果瓶颈往往不在模型,而在「检索得到什么」。
调提示词的收益,远小于把切块和检索策略做扎实。
项目截图